요약
문제 정의
실기 강화학습의 병목은 알고리즘보다 보상과 학습 조건의 설계에 있습니다. Eureka·RDA 같은 LLM 기반 보상 설계는 대량 병렬 시뮬레이션에서 후보마다 학습을 반복하는 방식이라 에피소드 하나가 실제 시간을 쓰는 실기에는 그대로 쓸 수 없습니다. 또한 실기에서는 안전 한계, 시동 조건, 리플레이 버퍼, 센서 보정처럼 보상 밖의 조건이 성패를 크게 좌우합니다.
대상 플랜트는 모터가 태양기어만 구동하고 유성기어를 매단 캐리어는 자유 회전하는 과소구동계입니다. 3D 프린팅한 PLA 기어의 정지마찰과 백래시 때문에 정확한 모델링이 어렵습니다.
시스템
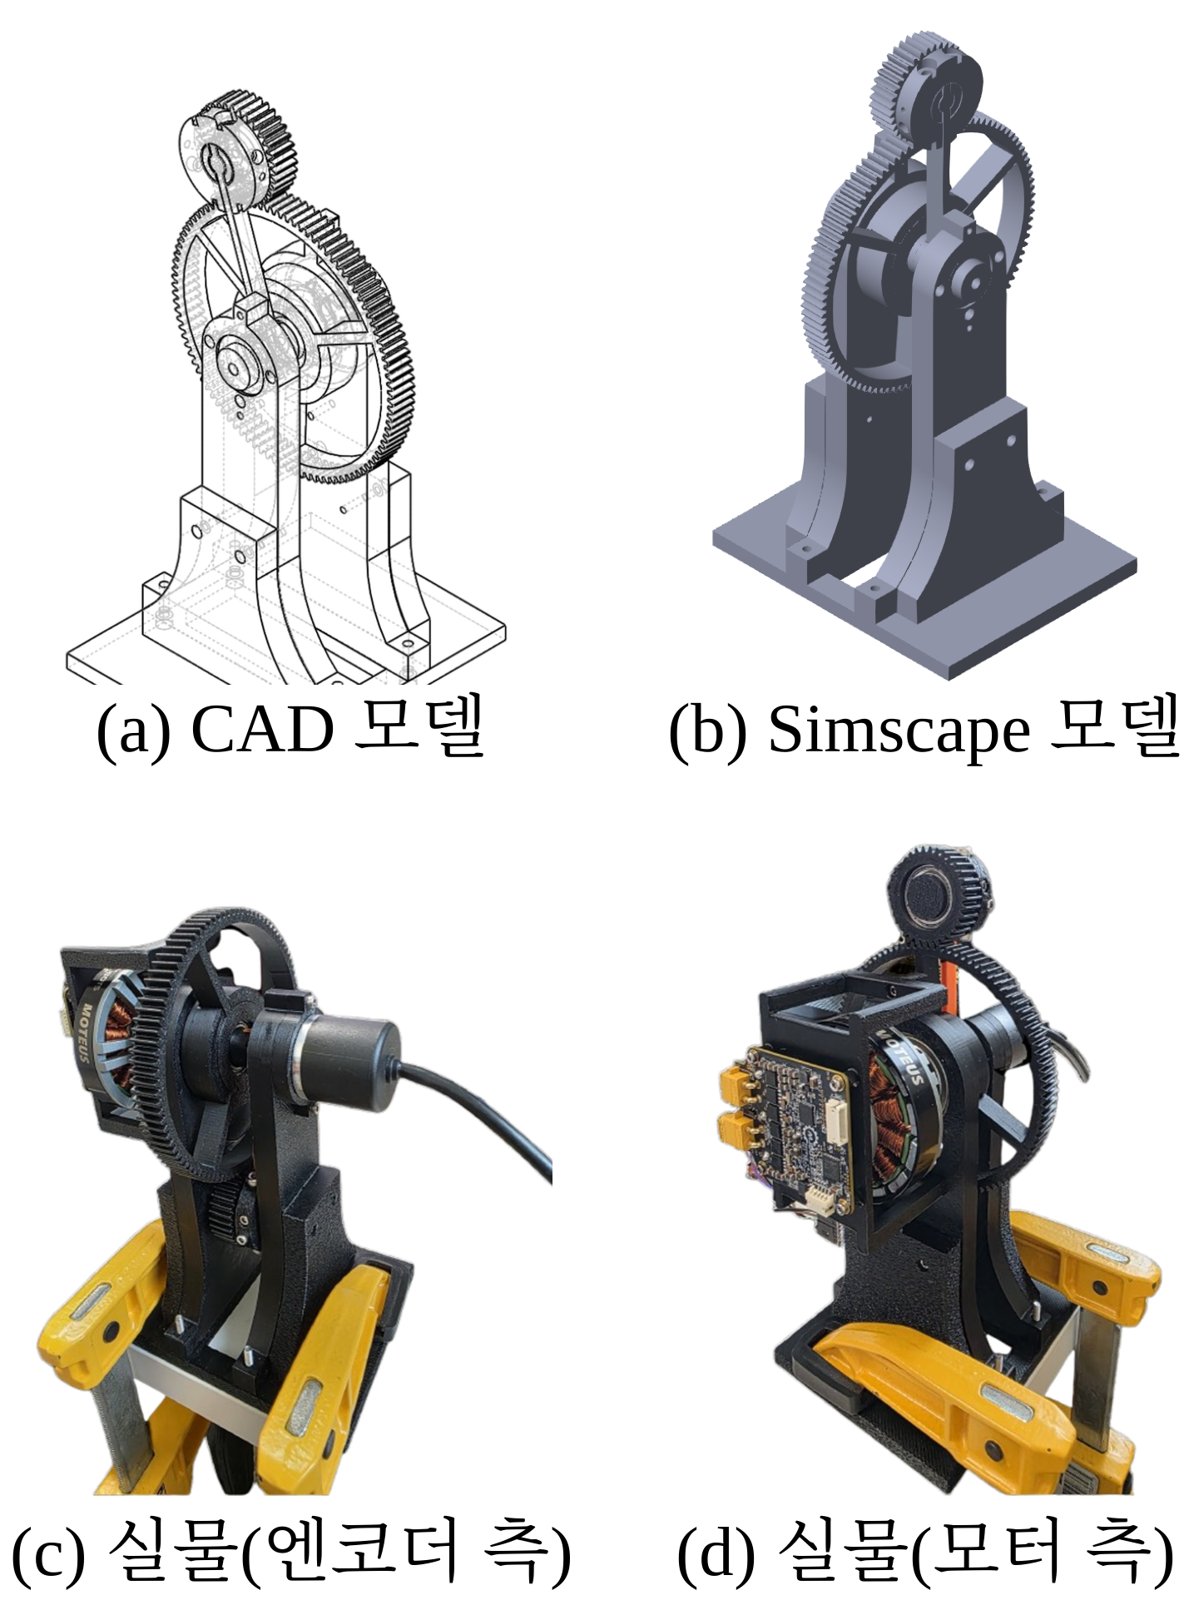
하드웨어
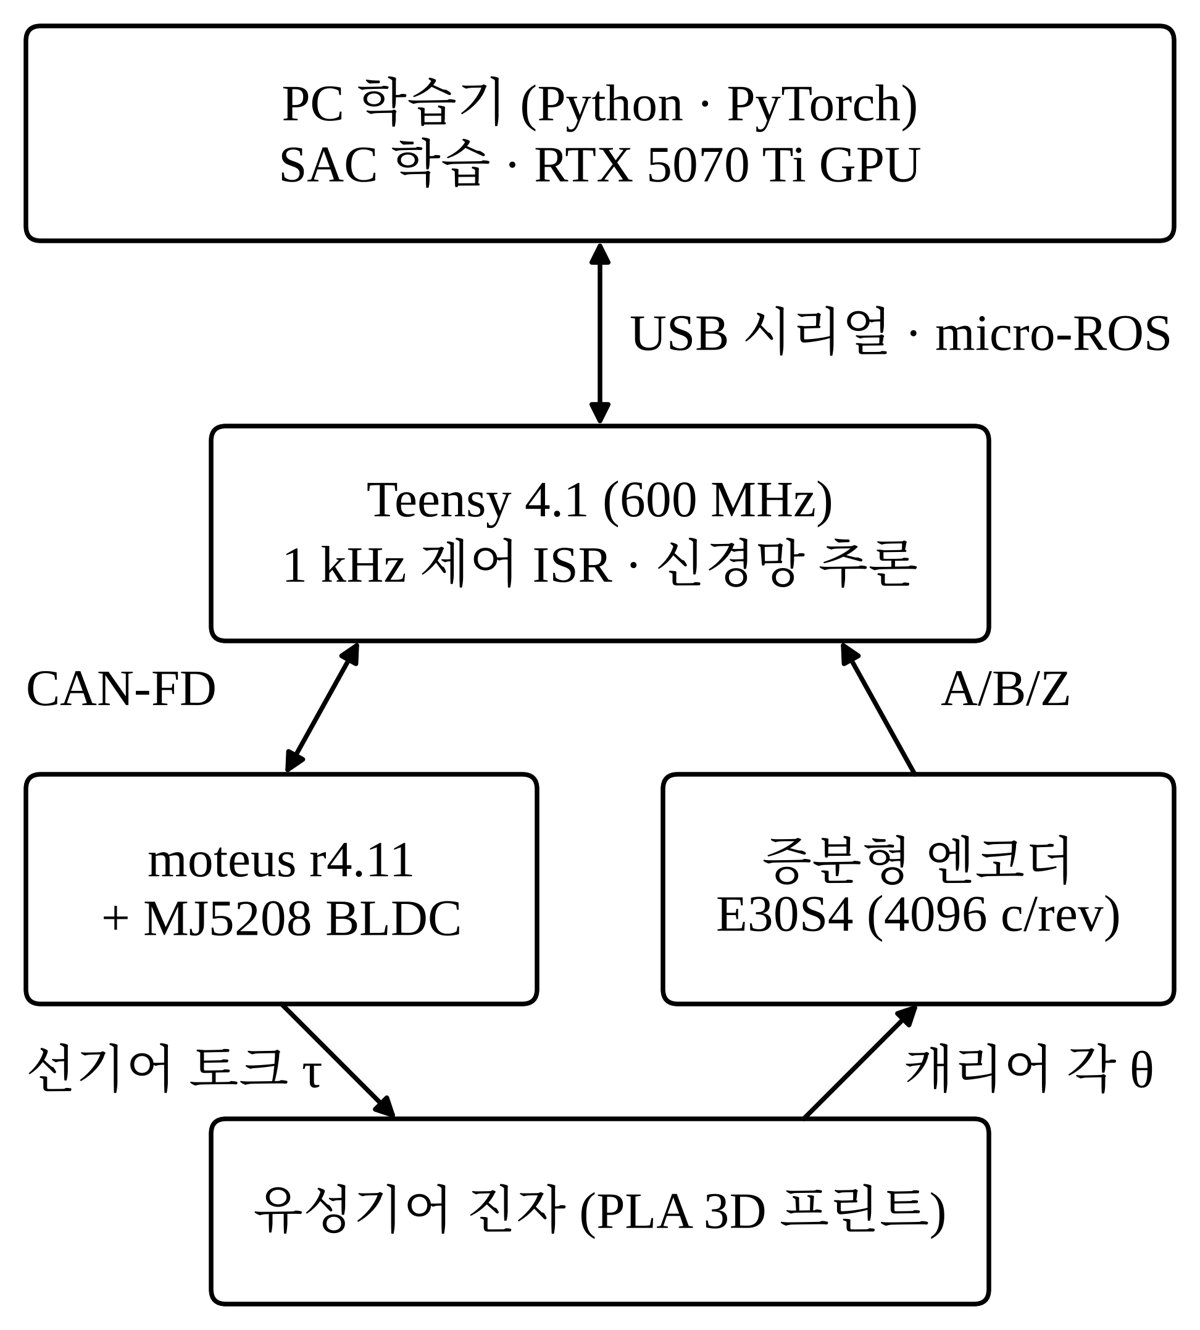
- Teensy 4.1 → CAN 트랜시버 → moteus r4.11 (CAN-FD 5 Mbps) → MJ5208 BLDC, 순수 피드포워드 토크 지령
- Autonics E30S4-1024 엔코더, 4체배 4096 count/rev, Z 인덱스로 12시 절대 영점 보정
- 토크 ±0.2 Nm 상시 제한, 각속도·모터 속도·공전·드라이버 무응답 기반 펌웨어 안전 계층
학습과 추론을 분리한 HILL 구조
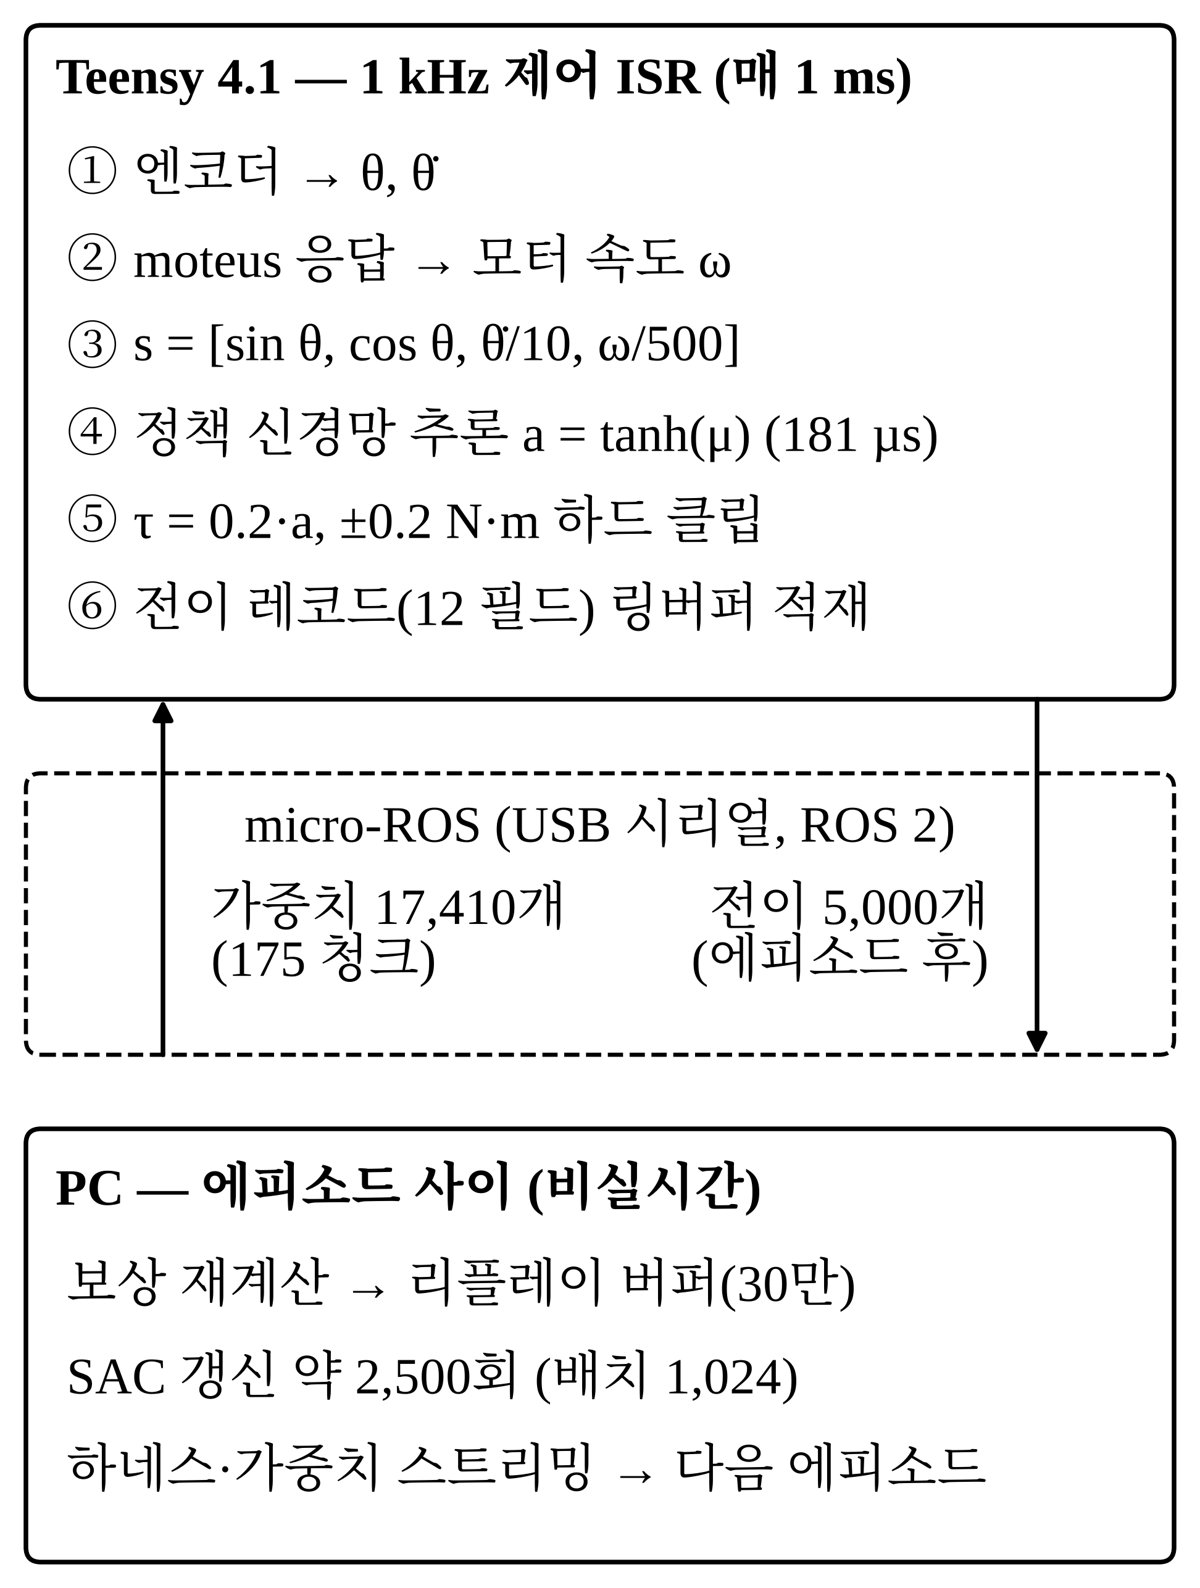
Teensy가 1 kHz 타이머 인터럽트에서 4–128–128–2 정책을 온보드 추론하고, 에피소드 동안 전이를 링버퍼에 쌓았다가 끝난 뒤 micro-ROS로 PC에 일괄 전송합니다. PC는 SAC(Twin-Q, γ=0.99, 배치 1,024)로 학습해 새 가중치를 다시 Teensy로 보냅니다. 원시 물리량을 함께 보내 보상함수가 바뀌면 버퍼 전체의 보상을 재계산(relabel)할 수 있게 했습니다.
RDA 기반 보상·하네스 공동 설계
RDA(Reward Design Agent)의 보상 탐색 문제에 학습 하네스 H를 탐색 변수로 더했습니다. 하네스는 신경망 가중치를 제외한 학습·실행 조건 전체(안전 한계, 시동 킥, Z 보정, 넉다운 리셋, 버퍼, 보상 계수 등)입니다. 실기에서는 병렬 탐색이 불가능하므로 한 번에 하나의 처방을 적용하고 결과를 판독하는 순차 루프를 택했습니다.
(R*, H*) ∈ argmaxR,H S( L(EH, R, H), I )
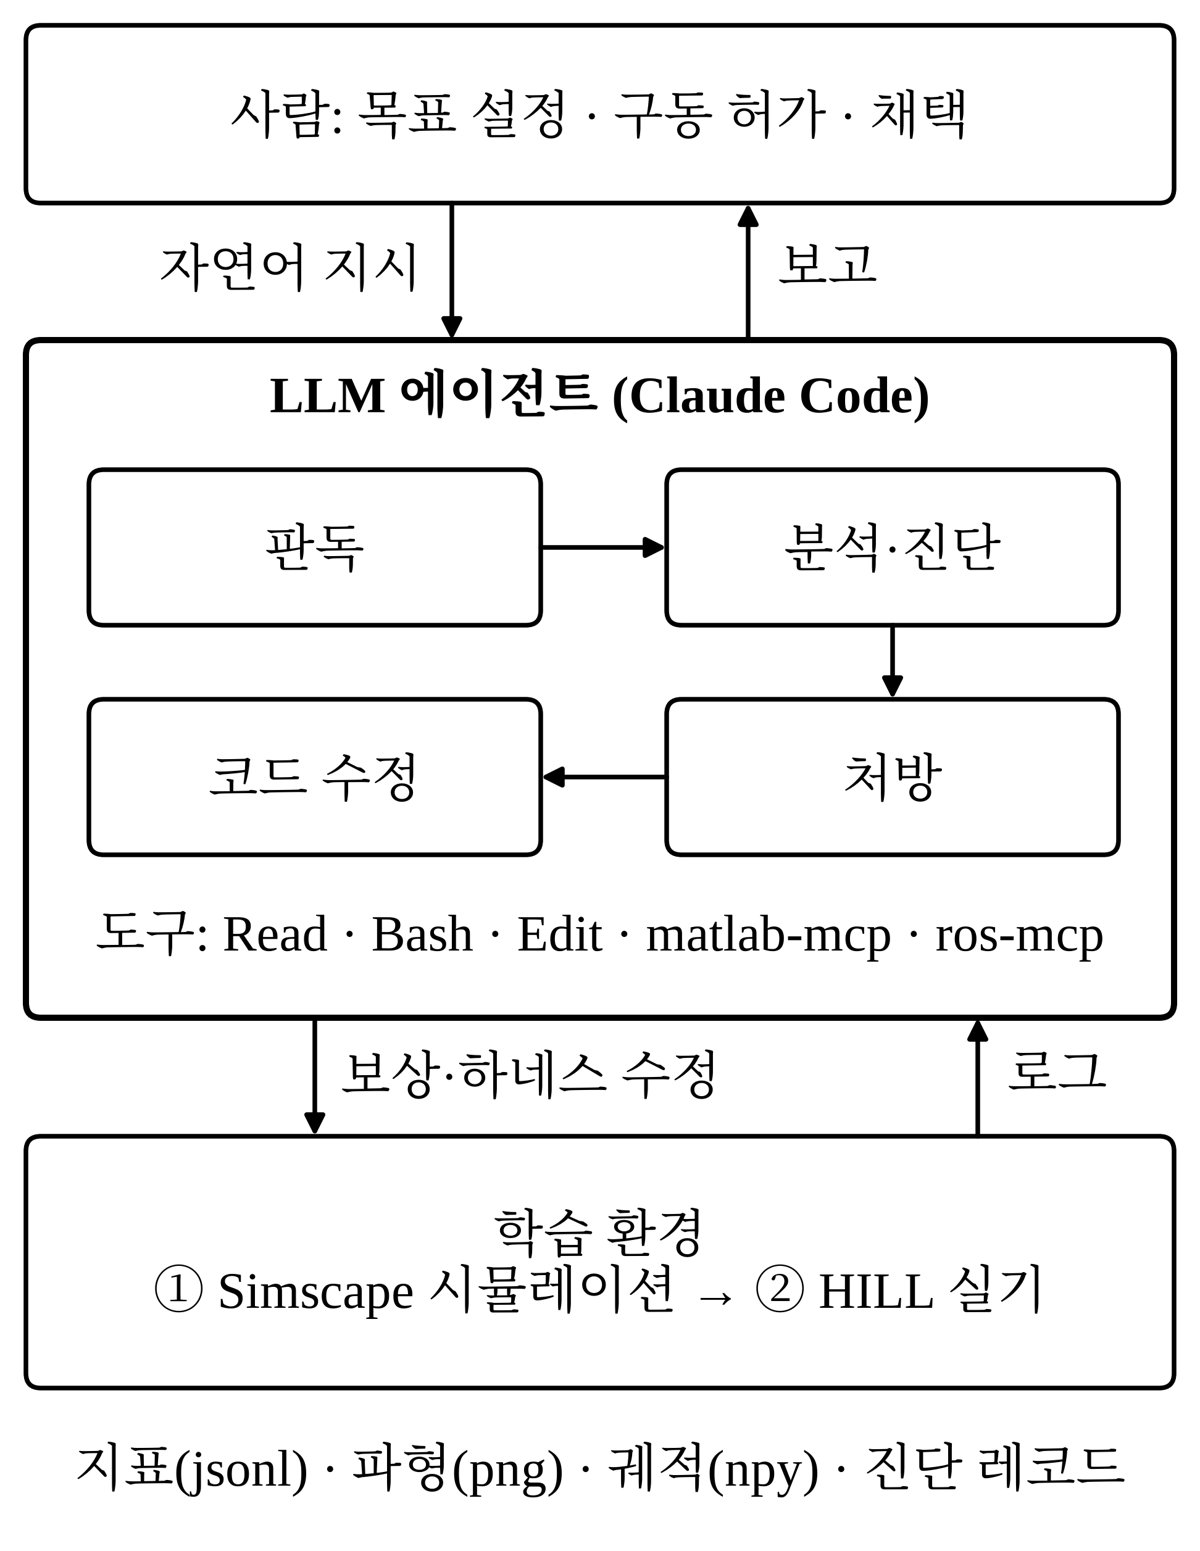
- 관측 압축: 에피소드당 약 6만 개 수치를 지표 한 줄(
metrics.jsonl)과 파형 대시보드(live.png)로 압축해 에이전트가 읽음 - 도구: Read · Bash · Edit · matlab-mcp · ros-mcp
- 안전: 실제 모터를 돌리는 모든 명령은 사람의 명시적 허락 필요 — 피드백 루프 속 LLM 과최적화를 사람이 차단
시뮬레이션 사전학습과 전이 실패
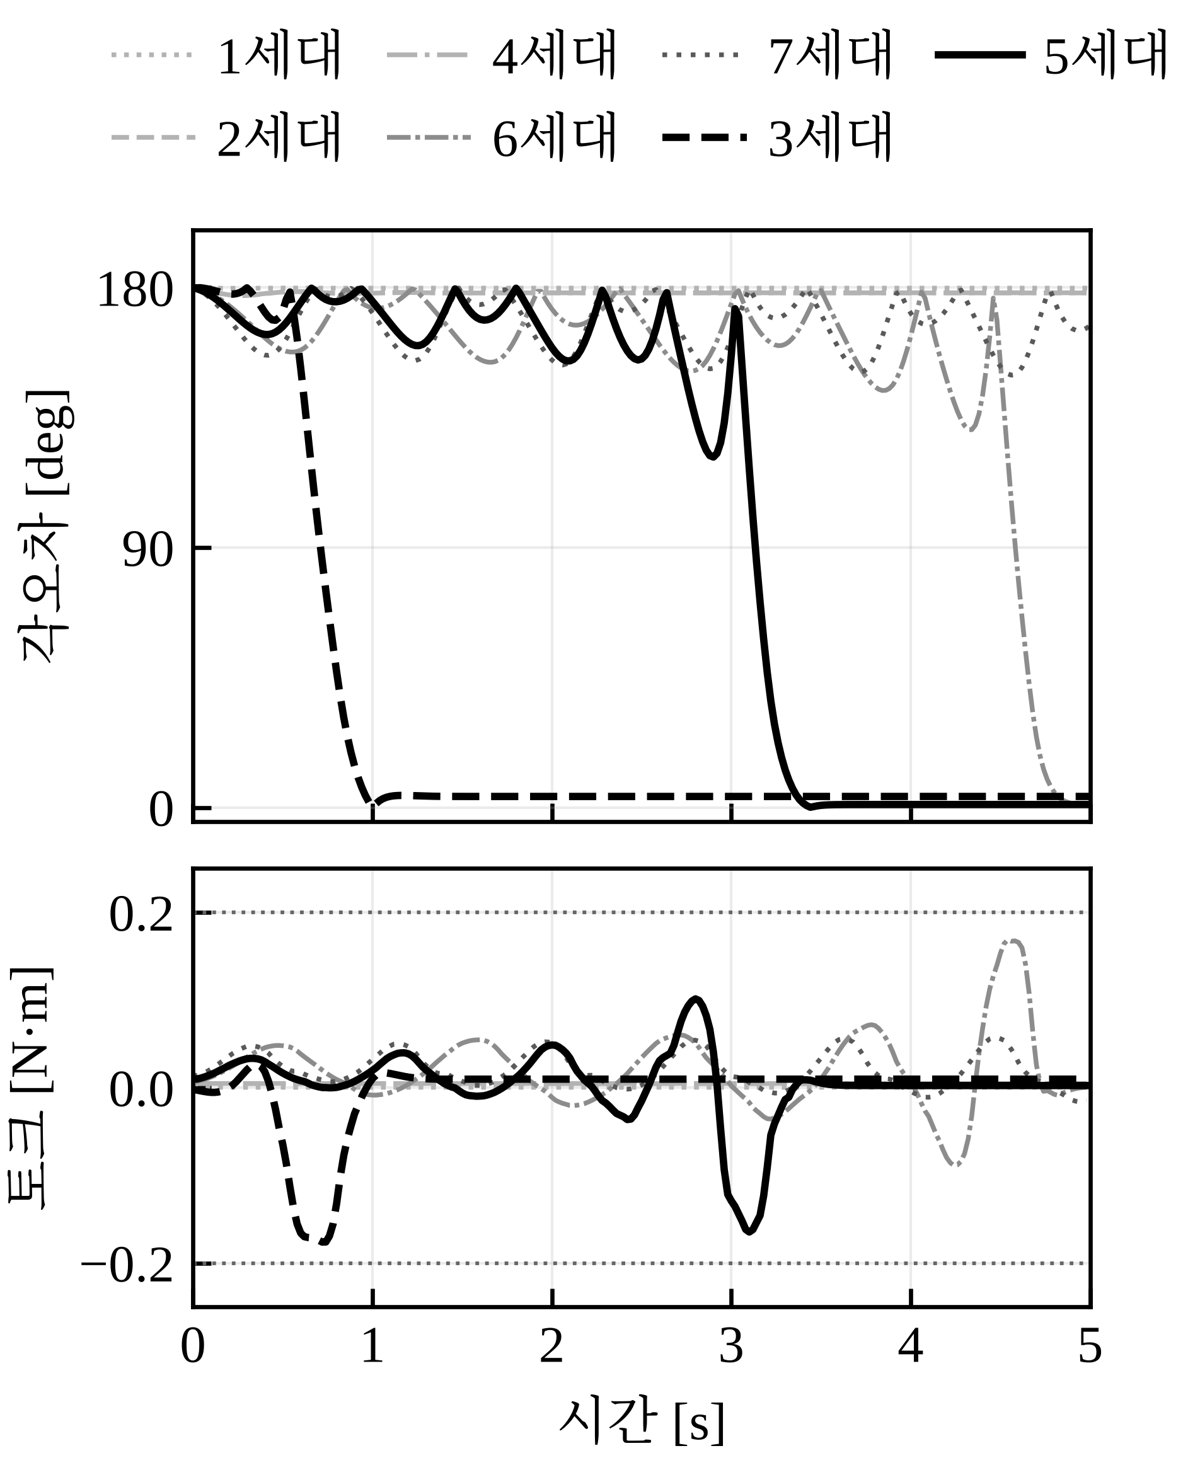
무작위 정책의 실기 탐험은 기구 파손 위험이 커서 CAD 모델을 Simscape Multibody로 옮겨 사전학습했습니다. 기어 마찰·백래시 모델을 추가하고 실기와 같은 관측·신경망을 썼으며, 250 에피소드를 한 세대로 세대마다 에이전트가 보상을 재설계했습니다. 7개 세대 중 정착 오차가 가장 작은 gen5(1.02°)를 실기 초기 가중치로 이식했습니다.
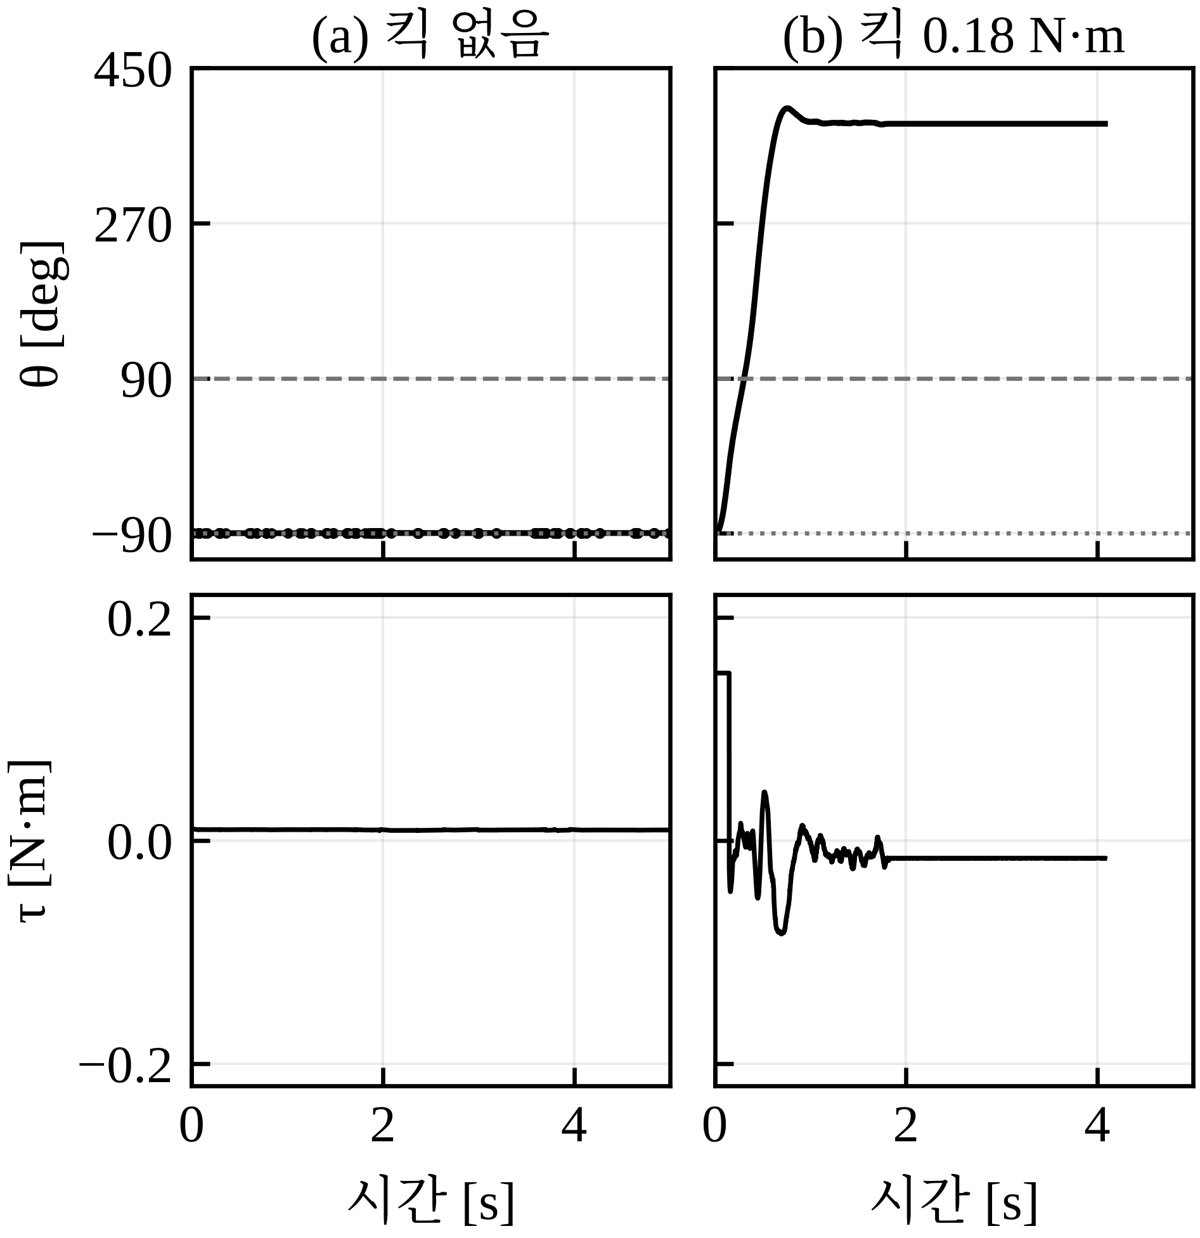
그러나 실기에서는 정지마찰을 넘지 못해 전혀 움직이지 않았고, 시동 킥을 추가하자 약 400°까지 과회전했습니다. 시뮬레이션 정책은 그대로 동작하지 않았으므로 이를 출발점으로 실기 데이터로 계속 학습시켰습니다.
실기 보상·하네스 13단계 진화
처방 영역은 보상(R), 하네스(H), 학습 설정(P)으로 표시했습니다. 각 단계는 직전 최선 정책에서 웜스타트했습니다.
| 단계 | 영역 | 주요 조치 | 정착 [°] |
|---|---|---|---|
| ① | – | gen5로 구 기어 HILL 학습 | 1.04 |
| ② | – | 새 기어 교체, ① 정책에서 이어 학습 | 2.9† |
| ③ | R | 보상 계수 자동 탐색 | 2.87 |
| ④ | R | 탐색 계수 고정 | 1.33‡ |
| ⑤ | R | 모터 속도 페널티 신설 (보상 해킹 차단), σp 0.25→0.15 | 0.71 |
| ⑥a/b | – | 같은 보상에서 정밀/정숙 두 극단 출현 | 0.31 / 2.52 |
| ⑦ | R | 1−tanh 정밀 항, 정숙 게이트 q | 1.50 |
| ⑧ | R·H | 킥 부호 ± 교대, 에너지 펌핑 항 신설 | 0.35 |
| ⑨ | P | 리플레이 버퍼·비평자 초기화 | 0.62 |
| ⑩ | H | 시동 킥 제거 | 0.86 |
| ⑪ | H | 킥 ± 교대 복원, Z 보정 재측정 | 0.18 |
| ⑫ | H·P | 킥 제거, 버퍼 100k→300k | 0.70 |
| ⑬ | R | 정밀 항 폭 0.05→0.03 (샤프닝) | 0.35 |
† 궤적 미보존(기록값) · ‡ 꼬리 유실로 무효
핵심 장면: 정밀–정숙 트레이드오프 (⑥→⑦)
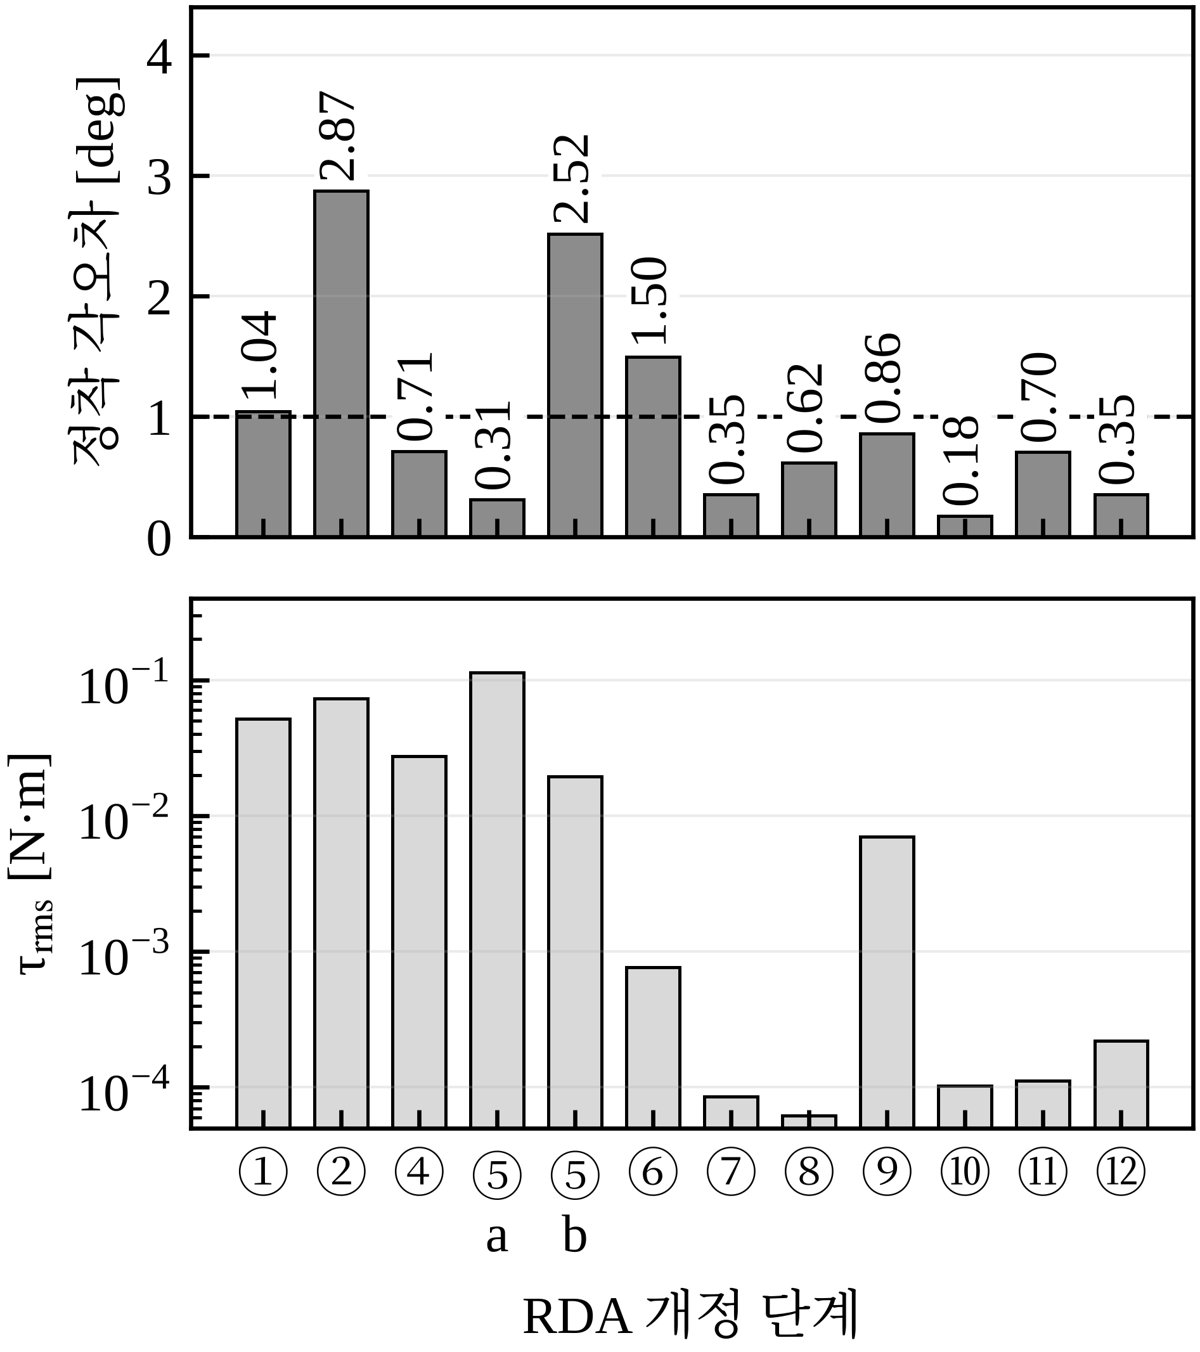
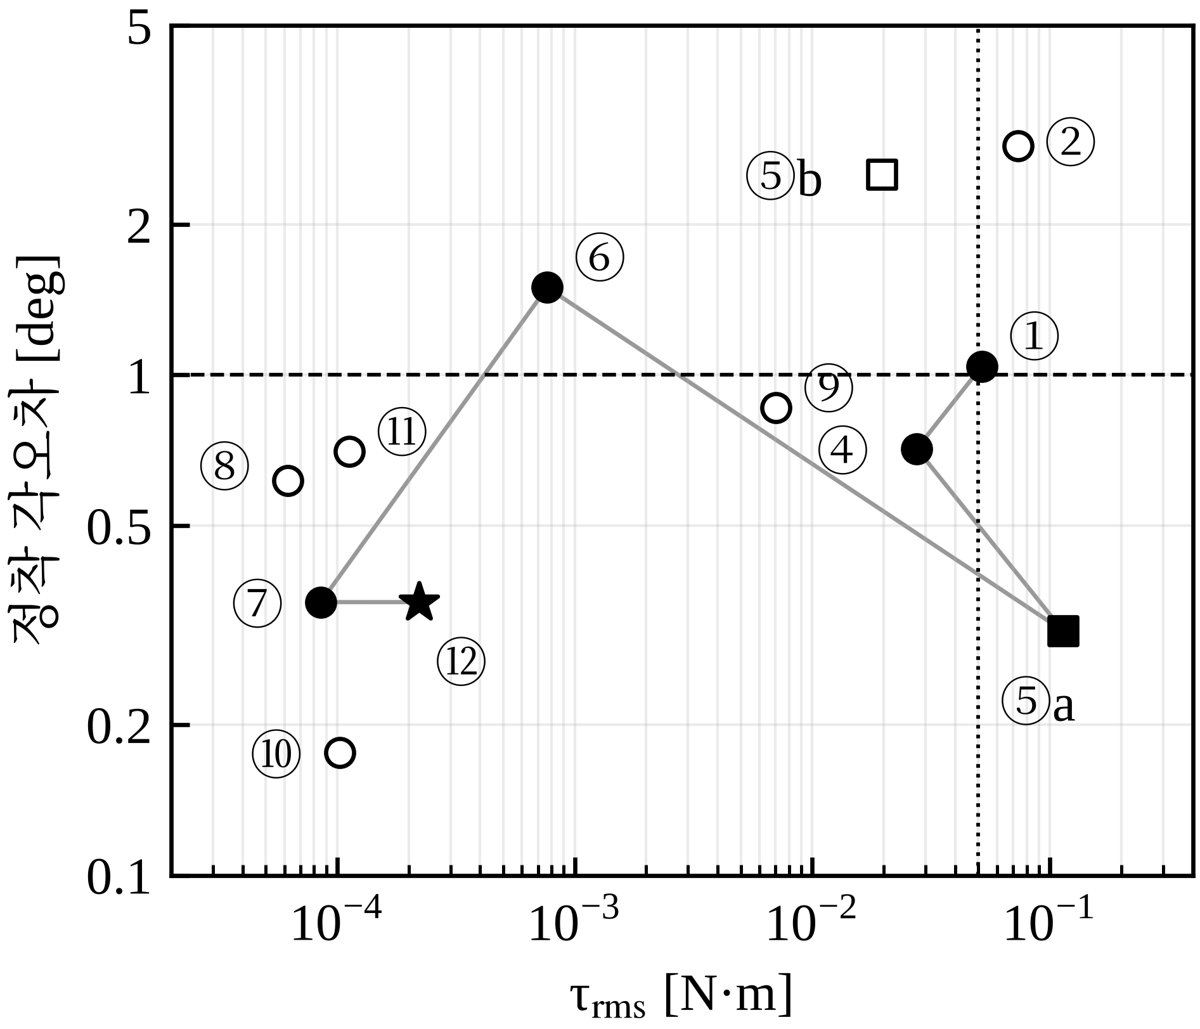
같은 보상에서 정밀하지만 시끄러운 정책(0.31°, 0.1135 Nm)과 조용하지만 부정확한 정책(2.52°, 0.0195 Nm)이 함께 나왔습니다. 에이전트는 유지 구간 토크를 회귀해 정책이 일정 토크 + 비례 이득으로 근사됨을 보이고, 가우시안 근접 항이 상단에서 거의 평탄해 0.5°→0 개선의 보상 이득이 0.015에 불과하다는 것을 찾아냈습니다. e=0에서도 기울기를 유지하는 1−tanh 정밀 항과 정숙 게이트를 도입하기 전, 기존 궤적으로 보상 순위를 미리 계산해 의도한 순위가 보존되는지 검증한 뒤 적용했습니다.
결과
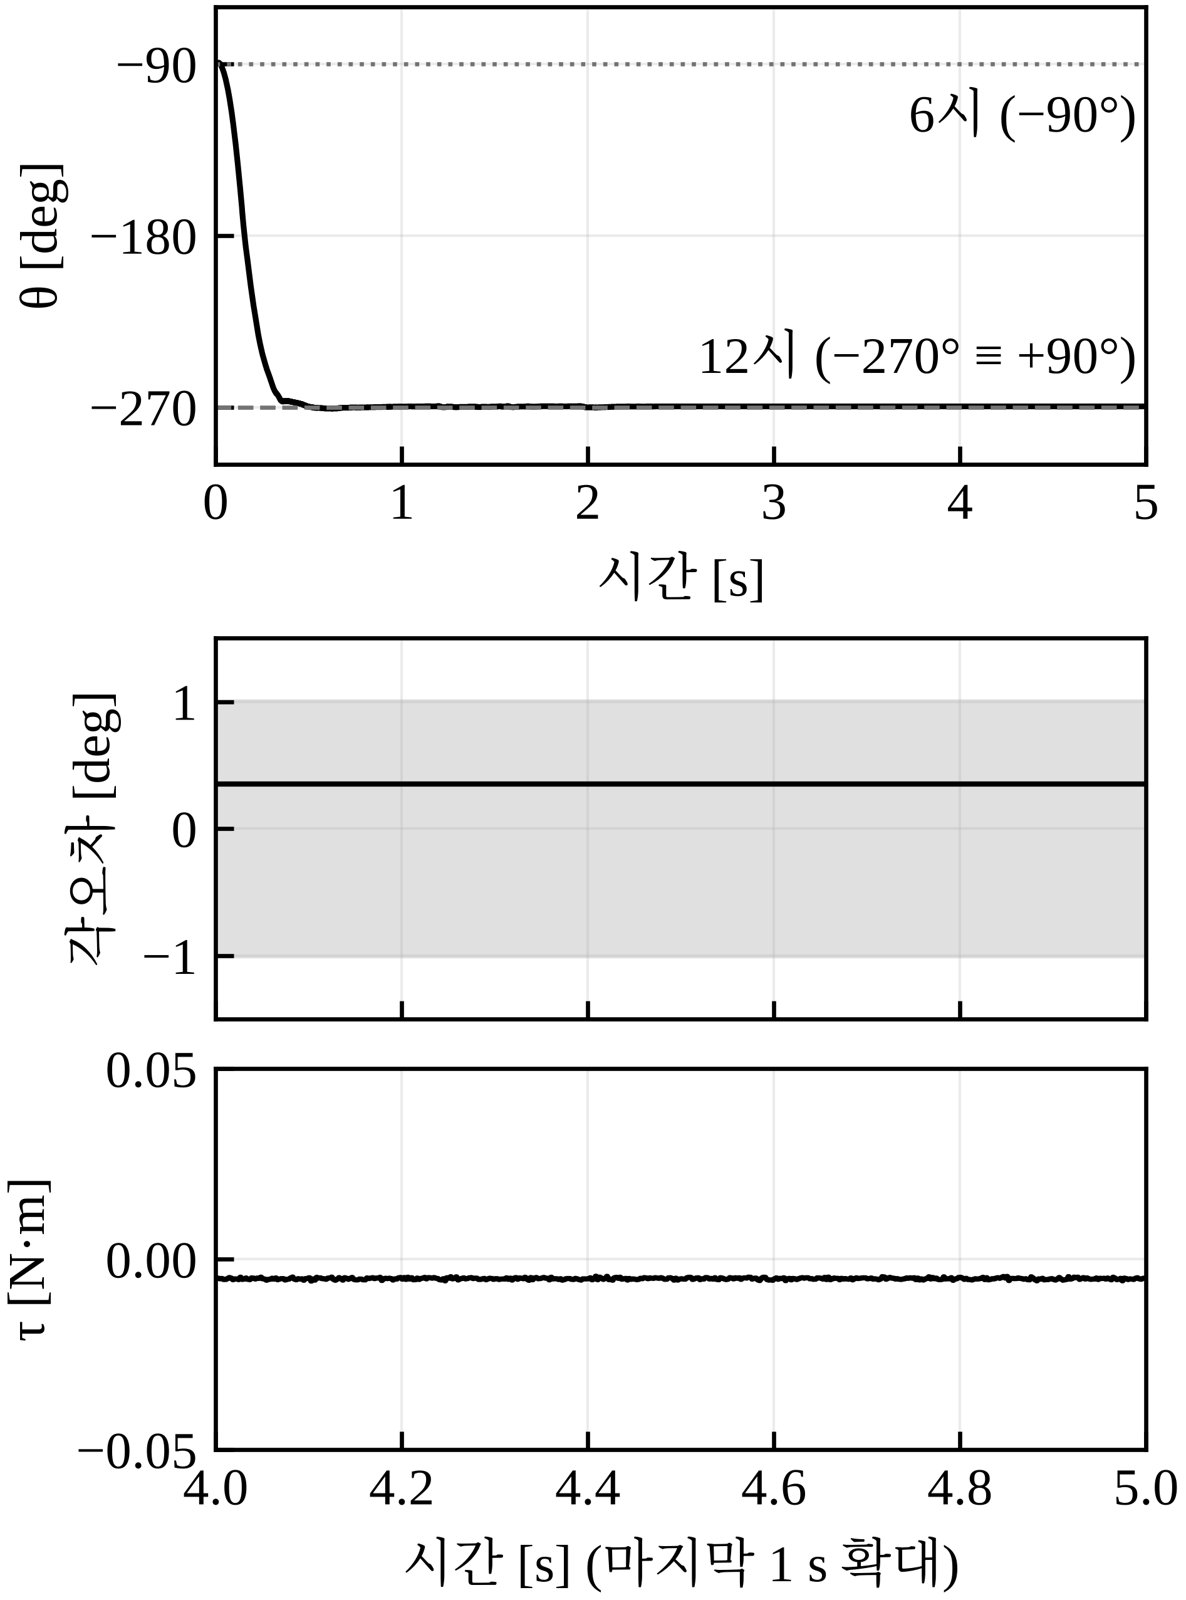
최종 정책 ⑬은 킥 없이 0.34 s에 스윙업하고 정착 0.35°, |e|<1° 체류율 100%, 유지 토크 RMS 0.0002 Nm로 모터가 거의 정지한 상태에서 진자를 유지했습니다.
학습에 없던 외란에 대한 거동
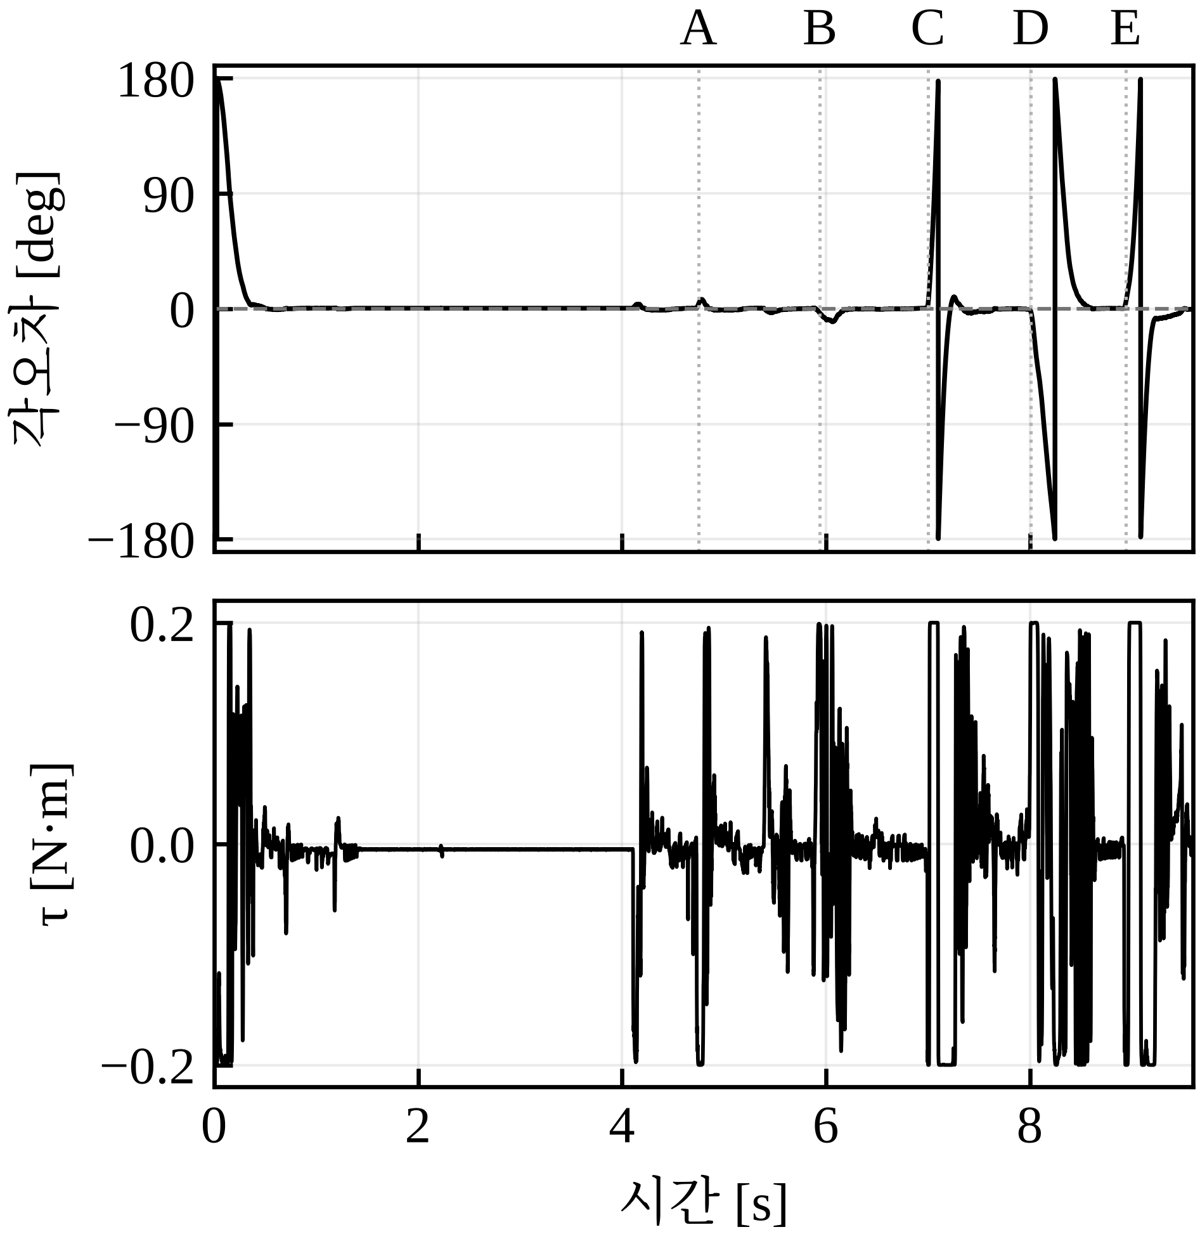
학습은 모두 6시 정지 상태에서 시작했고 외란 복원 보상도 없었지만, +7.2°/−10.3° 외란을 0.080/0.219 s 만에 복원했고 6시 부근까지 넘어뜨린 큰 외란에서도 0.315–0.551 s 만에 재스윙업했습니다. 흥미롭게도 정책은 외란을 거슬러 되돌아오지 않고 운동에너지를 보존한 채 한 바퀴 넘겨 반대편 12시에서 다시 포획했습니다 — 토크 한계 ±0.2 Nm에서 합리적인 전략입니다.
배운 점 · 한계
배운 점
- 질적 향상은 하네스에서 나왔다 — 양방향 포획과 무킥 스윙업은 보상이 아닌 하네스 조치(⑨–⑫)의 결과였습니다.
- 실기에서는 지표 자체가 틀릴 수 있다 — 꼬리 유실, 엔코더 계수 누락, 축 미끄럼(최대 8.61°), Z 영점 오차, 보상 재계산 오류(버퍼 43.7% 과대 보상)를 에이전트와 함께 찾아 고쳤습니다.
- 사람의 감독은 여전히 필요하다 — 지표 기반 진단이 반대 방향 처방을 내릴 때 파형 판독과 사람의 판단이 이를 바로잡았습니다.
한계
- 단계별 정착 오차가 대부분 greedy 궤적 1개에서 계산되어 신뢰구간이 없음
- 고전 제어·사람이 설계한 보상·보상 고정 SAC와의 비교, LLM 기여를 분리하는 절제 실험 부재
- 학습 중 기어·디코더·축·영점이 바뀌어 단계 간 비교가 엄밀히 통제되지 않음
다음 단계
- 하드웨어를 고정하고 주요 정책을 각 20회 이상 평가해 평균·표준편차 보고
- 학습된 신경망 정책에서 사람이 이해할 수 있는 제어기 수식 추출 → 신경망 추론 없이 MCU에서 구동하고 성능 비교 (후속 연구: CEA)
- VLM으로 실기 영상을 판독하는 Visual RL 버전으로 확장 (별개의 후속 연구: RDA 기반 Visual RL)